既然AI什么都会,那我们学习的意义是什么?——— 我的回答
Oct 8, 2026
{"summary":"文章从一篇 DeepSeek 算法工程师对 AI 进化能力感到后怕的文章说起,引出作者自己的焦虑:AI 技术迭代极快,框架与概念数月即被淘汰。作者在朋友推荐下读到这本 Agent 书,此前啃《从零构建大模型》时卡在第三章多头注意力,本书最初只是替代品,但他认为其前三章目录结构扎实,胜过市面上大部分 AI Agent 底层原理书。作者的问题是:ReAct 已被 LLM 的思维链内化为基本能力,多模态也从只有 Kimi 一家扩展到各大厂商全面铺开,学习还有什么意义。书中给出的答案是:ReAct、Skills、Context、Loop 属于时刻在变的"术",不变的是底层原理即"道";以 skills 为例,其本质是应对上下文有限的渐进式披露与可热插拔设计,使 Agent 优化从修改集中式系统提示词转为分布式优化,并为领域知识沉淀提供路径。学习这些的意义,在于在大模型尚未内化该能力的几个月或几年里发挥其应有价值。作者另提到书中用实验数据具象化了注意力残差导致的前向传播结果差异。"}
问题来源
也是今年9月份一件非常火的文章 《我不得不把才华埋葬在昨天》,讲的是DeepSeek的核心算法工程师对于AI的进化能力感到的。后怕与思考,看完之后思绪纷纷。那么在我的领域中,我也有这样的担忧焦虑之处,在某些机缘巧合之下去接触到这本书,了解了 AI 的底层逻辑,才有了山穷水复疑无路,柳暗花明又一村的通透与明白。正所谓知其所以然也
这本书的背景
这本书是在朋友推荐下去接触的,在此之前,我自告奋勇的去啃了 从零构建大模型 这本书。前面通用型概念过得非常快,到了第三章介绍多头注意力,并尝试教会用代码写一个简单的可训练权重的注意力机制时,就明显跟不上节奏,甚至一个小节需要花费半天时间去理解它的底层概念。 然后就是关于这本书的故事,最开始,它更像是阅读《从零构建大模型》的替代品。但在最后,我不得不为这本Agent体系最完善、各种观点最深刻的书感到钦佩
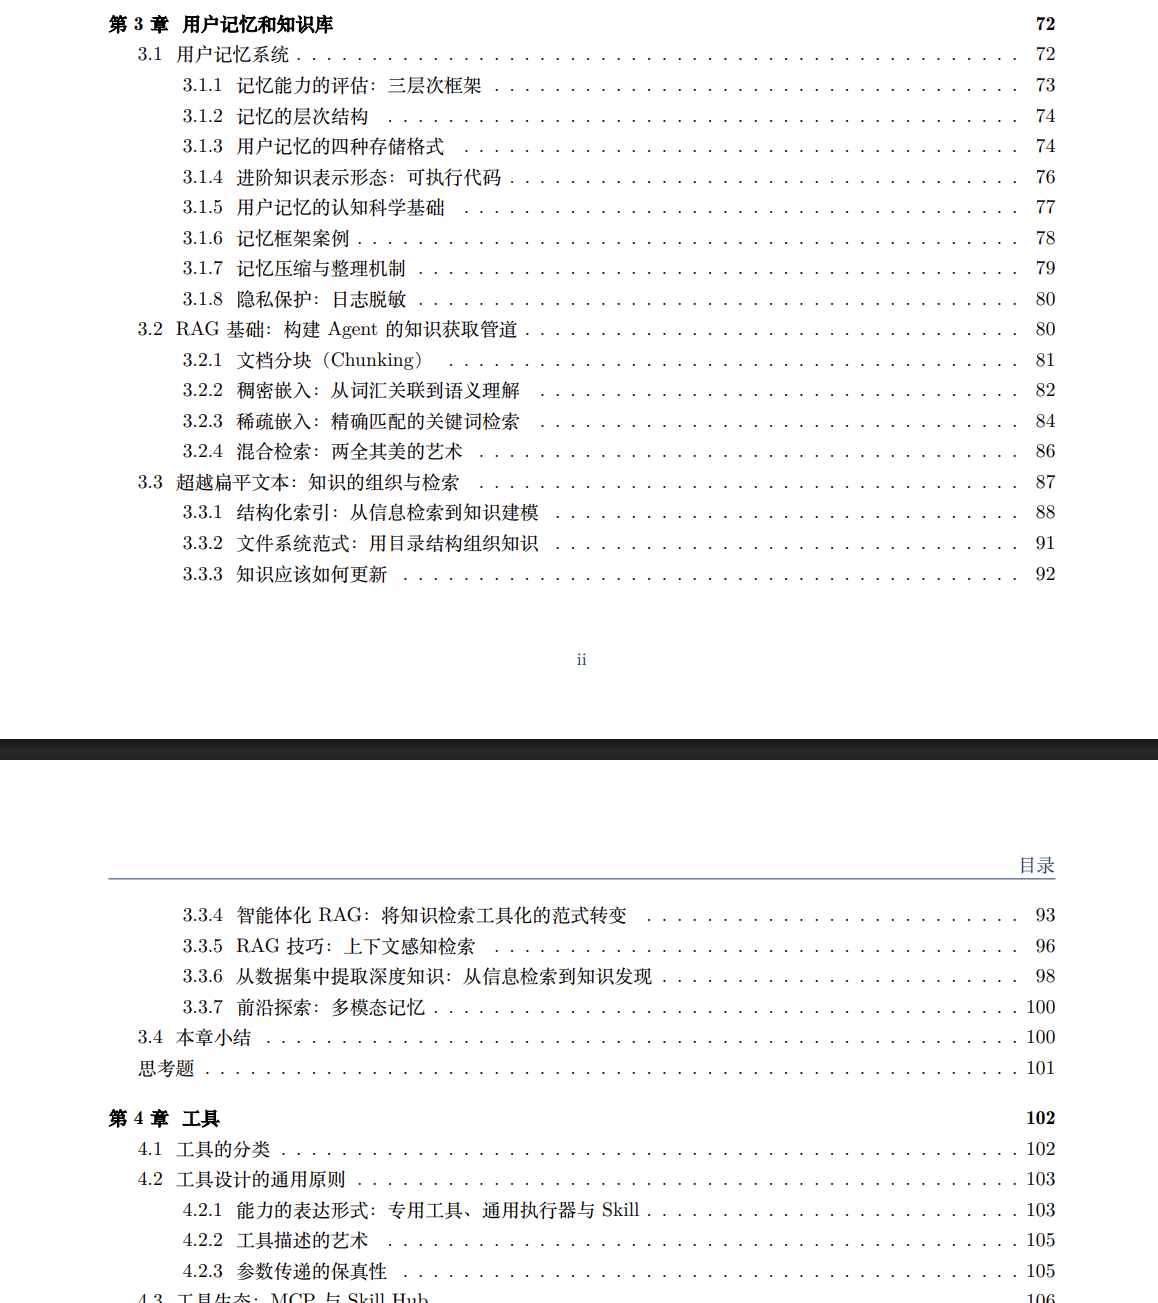
就拿目前看到的前三章来说,其目录结构的表面功夫,就足以胜任截止为今,80% 出版的所有有关AI Agent底层原理与实践书了。非常的扎实
我的答案
目前有关 AI agent 的技术百花齐放,百家争鸣,模型几天一个小版本,一两个月一个大版本,放在框架上,更为突出,数月前声明的 API 方式到几个月后就已废弃,开发者花费时间学习的概念与框架原理,等到几个月后就不断被淘汰,这不禁让我思考,学得慢是否就不需要学习?
举个例子,25 年下半年大名鼎鼎的 ReAct 模式去规划 Agent 的行为步骤。而到了今年,却已经被内化为 LLM 的基本能力,甚至不需要在框架中额外的声明规范代码,只要大模型拥有 CoT (思维链)。就能够实现 ReAct 这个循环, 又比如说从今年 2 月份开始,除了 Kimi 一家独大的推出多模态,像其余的 DeepSeek, Qwen, GLM。都不支持多模态,所以各大开发者费尽一切办法桥接多模态模型。而到了今年六七月份,各大厂商已全面铺开多模态。所以这种前沿的技术设计模式不断的内化进大模型,这引发的问题和前文中类似,我们学习的东西在不久后就会被 AI 内化进模型的基本能力。那么我们学习的意义何在呢?
就带着这个问题,我看了这本书的前三章,书中似乎已经找到了答案…
ReAct, Skills, Context, Loop, 这些只是术的层面,而术是时刻在变的,不变的就是底层的原理,称之为道,就比如 skills 可以换一个名称或者换一种包装方法,但 Agent 由于上下文有限,所以需要一种渐进式披露的设计模式去按需加载上下文,有了这一点还不够,当引入了 skills 这种东西,优化 Agent 从原来的通过修改集中式的系统提示词,变成这种分布式的优化,甚至可以对这个渐进式披露工具进行独立开发与测试,甚至分享 为了给这个具有颠覆性技术的大跨步取个名字,所以它叫做 skills, 另一个原因也是当时 Agent 系统缺乏一种独特领域知识的沉淀。所以借用这个渐进式披露,可热插拔的这个东西,也为领域知识的沉淀提供了一条可持续的路径。所以你看,这本书中不是教你 skills 的结构应该怎样写,渐进式披露要怎样设计,而是在教更底层的东西。
基本读到书中所触达的深度,就能够自发地明白,比如像 ReAct、skills 或者说 Harness,虽然不可避免的未来某一天它会逐渐被大模型内化掉。但学习这些的意义就在于,在大模型还没有内化这个能力的几个月或者几年中,将这个概念发挥它应有的价值。
Tips:
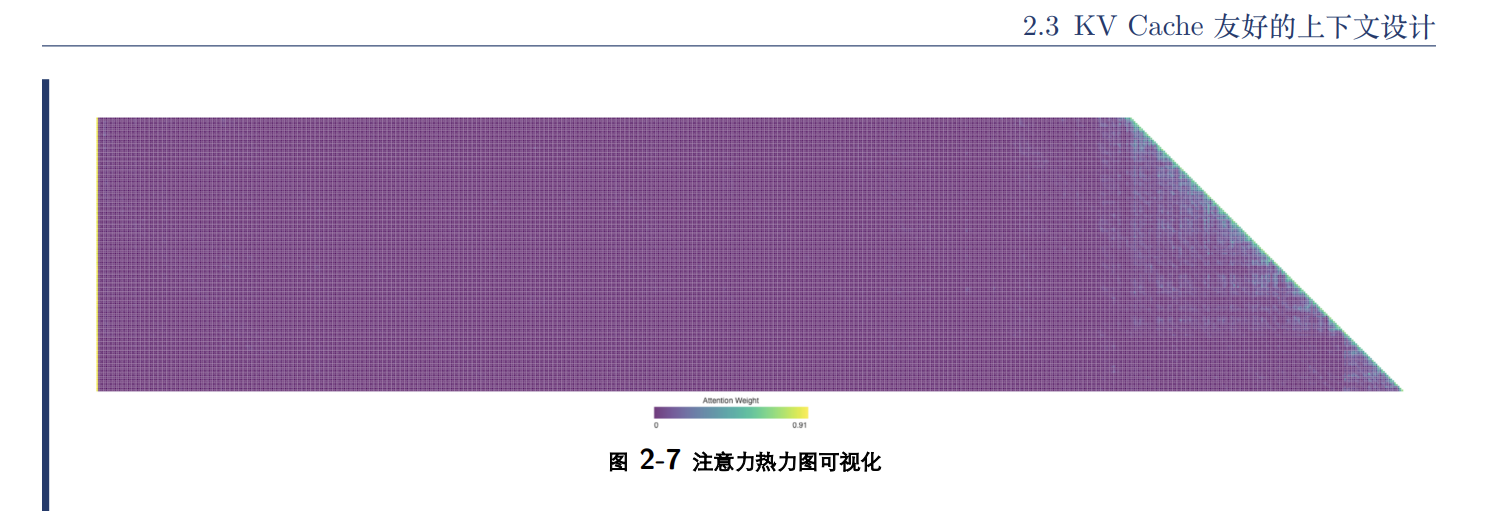
我印象中比较深刻的知识点是在介绍注意力残差的时候,用具体实验的数据场景去表象化了,用 Transformer 底层的计算前向传播到最后的结果,因为注意力分布的不同而导致结果的不同,非常形象👌
Loading comments...