关于从 0 到 1 构建 RAG Agent 构建的心路历程
Sep 20, 2026
作者从2022年起积累了大量技术文档,目标是打造定制化RAG工具管理数百万字资料。2025年使用飞书知识问答后感到难用,指出其检索精度不足、提问次数受付费限制、设计仅是召回分块整理输出三个缺点,今年6月起从MVP开始构建并经历一次大版本迭代。文中列出实际难点:Obsidian插件样式与语雀、Notion导出文档格式转换不佳导致符号包裹信息,纯表格文档切块噪声大,个人分段习惯产生无信息的小分块,因此做了定制化切分;检索方面认为BM25常把“AI Native”拆成AI加Native造成副作用。作者在7月搁置项目并补读AWS、货拉拉、Anthropic等相关资料后,理解到RAG Agent需重点开发记忆系统(参考openclaw的Dreaming与淘汰机制)、支持多节点流转、工具调用、多轮思考和本地读写。文末10月1日记录称许多文档检索不出来,GraphRAG、Raptor等缺乏整理结构,只是单向数据管道,应抽象为规则并按规则建立索引。
Note: This page does not support English, using the default language version
故事背景
从22年到现在,自己累积了不少的技术资产, 如何去管理这些文档是一个非常有价值的问题
在25年的时候,我用过飞书的知识问答,它能把企业的文档,你与其他人的对话,多维表格统一的收录知识库,你通过提问,他能够以图文的方式回复相关的有关信息
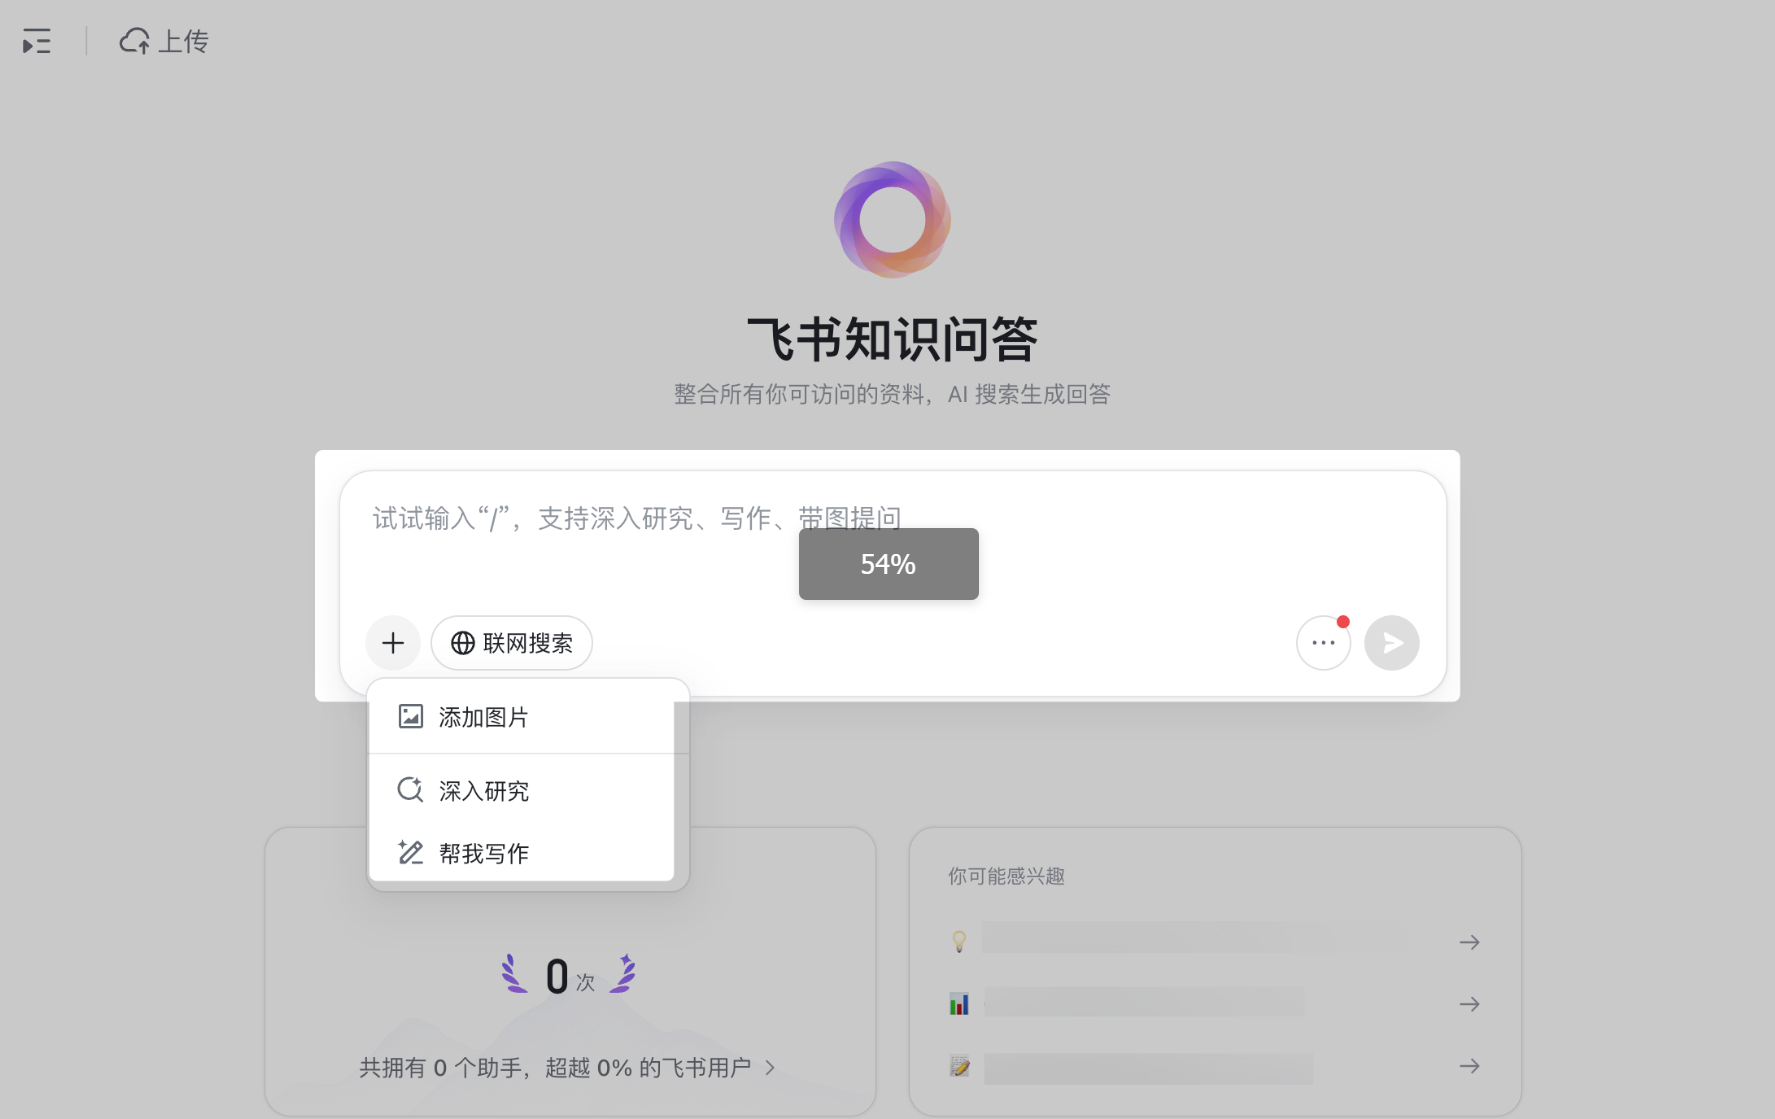
起初感觉很惊艳,在用过一段时间后不自觉地感觉到难用。它有三个缺点
- 检索精度严重不足。
- 要花钱。即使是付费企业套餐,每年的提问次数也是有限的
- 设计简单,只是一个根据召回的 trunk 整理回复输出的 API
它的优势是能够接入飞书的多种数据格式。除了这个优势,其余的体验。 emmm…
今年早些其实就有这个想法,去构建这么一款 Agent,管理自己数百万字的文档, 我不希望用市面常见开源的产品,而是想为自己打造一款定制化的 RAG 工具,帮助我检索对应资料。
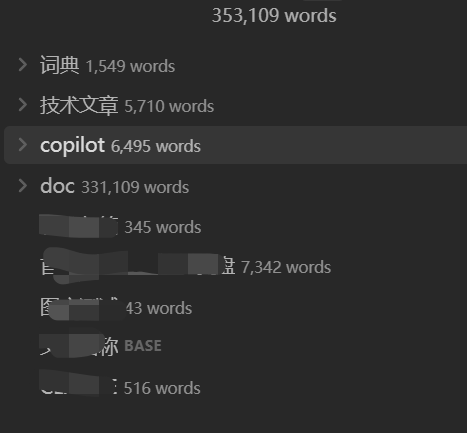
所以从今年的 6 月份就开始这个工具的构建,恶补非常多的文章,从 MVP 一步步走到现在,也经历过一个大版本的迭代了。也是从能用变得慢慢好用起来了。所以写下这篇文章来分享关于构建 Agent 中遇到了哪些问题
看上去简单,实则非常难做的点
我的资产结构非常单一,无一例外都是 markdown 文档,所以不需要加入 PPT、结构化数据、word 等解析的逻辑,看起来简单但这也不是一个轻松的活。
我使用 Obsidian 作为笔记软件,这里面通过插件定义了非常多的样式,但这些样式都不是 markdown 格式,比如下面的背景颜色格式
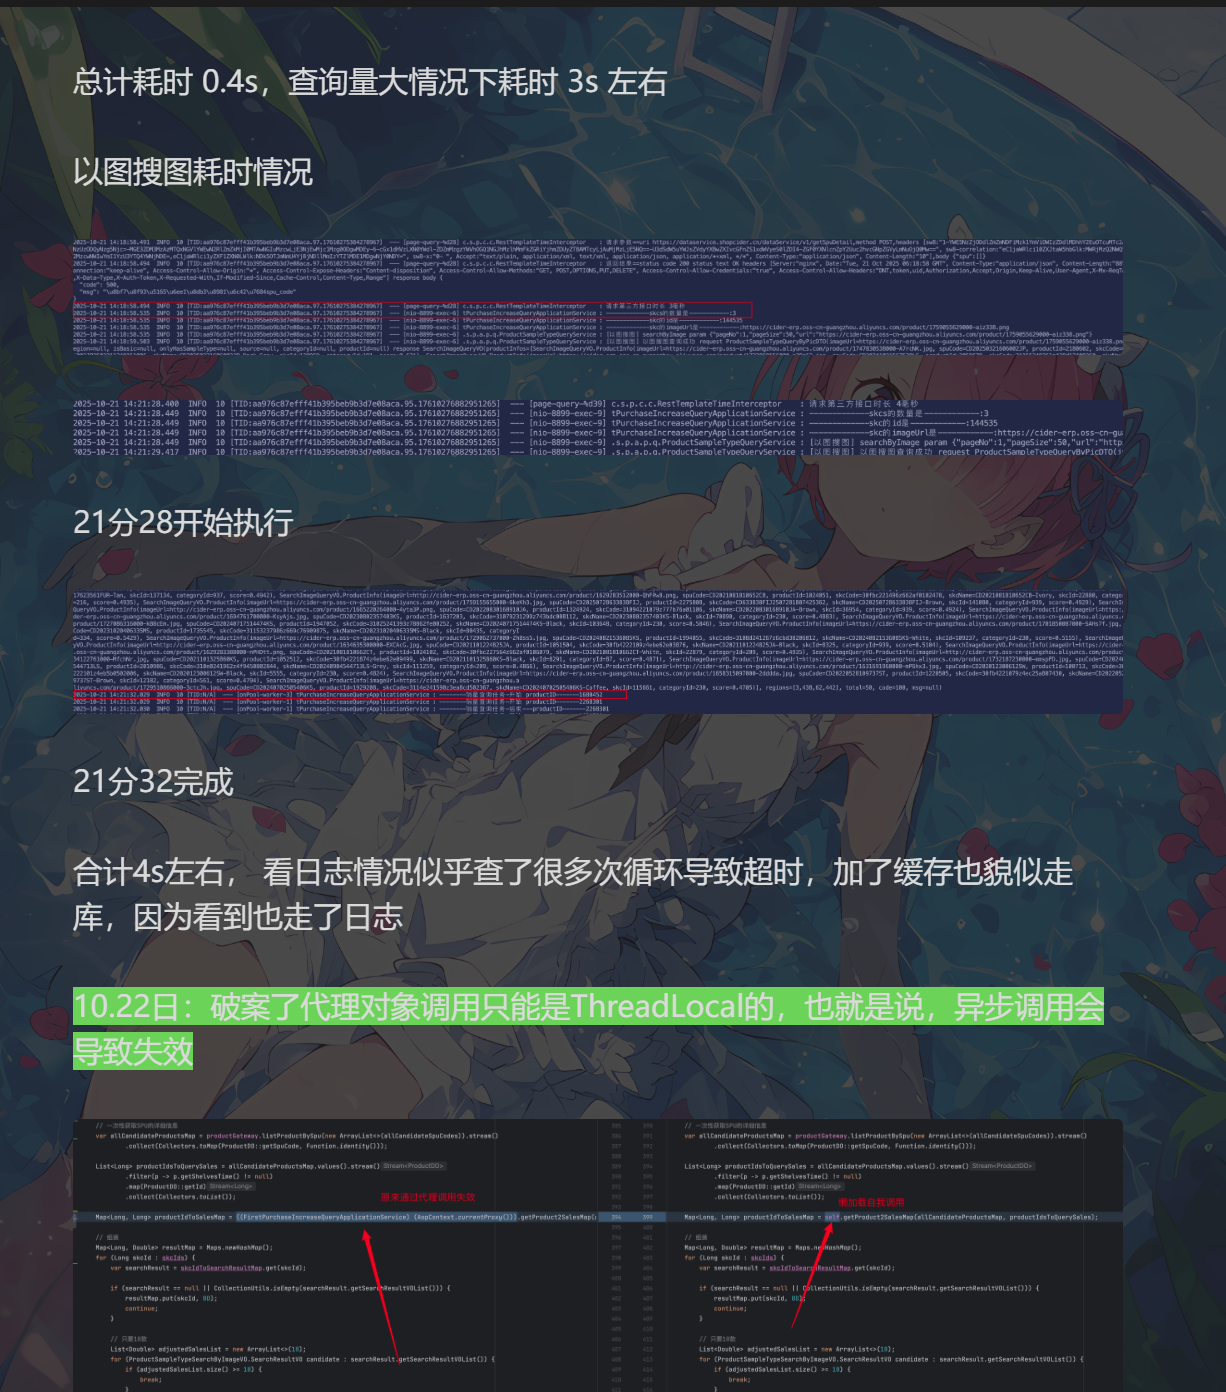
实际上,源代码是
<font style="background-color:rgb(98,210,86);">10.22日:破案了代理对象调用只能是 ThreadLocal 的,也就是说,异步调用会导致失效</font>不仅仅是上面的 case,还有我从语雀,notion 笔记通过脚本导过来的文档,对于格式没有很好的转换。导致各种符号包裹着信息。是第一类问题
很多文档又是纯表格的形式,对于切块有很严重的噪声。这又是第二类问题。在后面进行使用的过程中,才发现一个毫不相干的问题,召回了表格里面的数据。
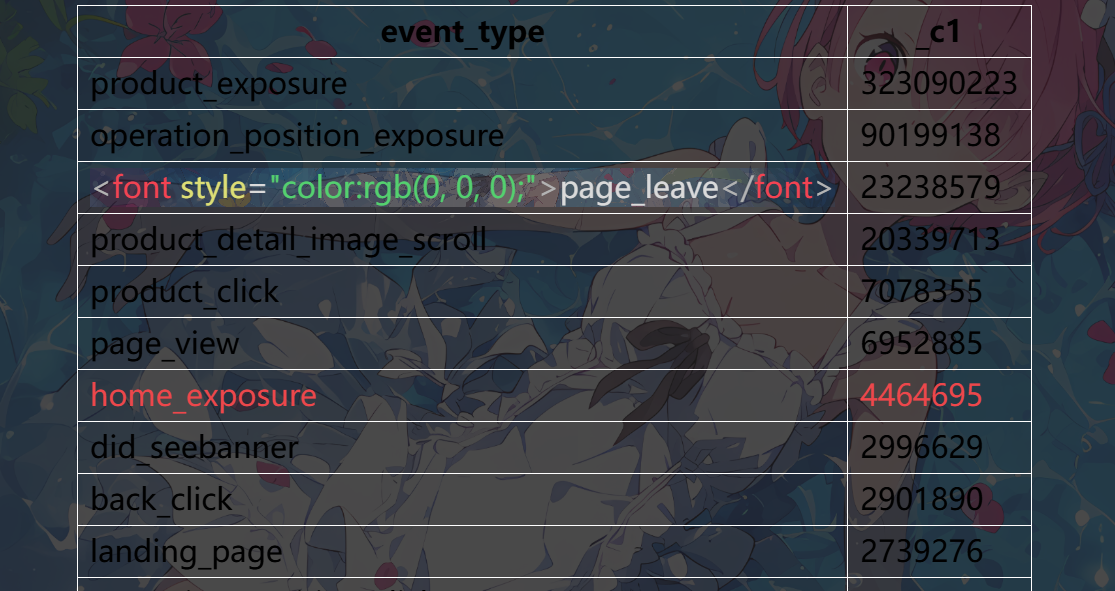
由于我做笔记或者文章有一个习惯,喜欢分段。也不喜欢起一些结构化的标题,所以就导致如果按照默认的策略去切分,那么将得到几十字的小分块。这召回的结果没信息。
所以后续也做了很多定制化的切分… 具体是如何针对 Markdown 做自定义切分会下期来讲
在检索方面,网上都说混合检索加 BM 25 加重排,但实际上我用下来甚至觉得 BM 25 是副作用
比如在这样一个场景,我们问AI native的相关事宜,BM 25就会把 AI Native 切成 AI + Native 去做召回,去做 web_search。如果不用 Agent 理解通用含义的话,简单的 rag 很容易掉进这个坑里,导致不能检索出有用的答案
什么是 RAG Agent ?
一个简单的rag问答助手,实现起来非常方便, 但是落地是非常困难的,需要考虑客户的实际资料格式,各种文件权限不同敏感资料的处理,那么一个相对复杂的 rag agent 设计更是难上加难。
在 MVP 最后一个版本,我发现 RAG 只是一个接收分块整理输出的一个中间节点。他的增强似乎是狭义的,不禁让我思考,这个工具的意义是什么?
然后在今年 7 月份把这个项目搁置了一段时间,恶补了一些底层的知识。就包括
- 取之有度,用之有节-从Harness视角破解Agent应用Token爆炸难题
- Agent 记忆系统的工程实践与演进
- 货拉拉大模型记忆系统(一):从提取到召回的工程实践
- Anthropic 电商 Agent 源代码
终于理解关于 rag 场景下 Agent 的设计。首先,对于成本来说,是不需要有特别的管控,不同于通用的coding agent, 它不会发送过多的上下文。
然后对于记忆系统需要着重去开发,这里参考了 openclaw 记忆系统的 Dreaming, 空闲时整理记忆。包括提取器的设计。包括记忆的淘汰机制都是造仿着成熟的产品去设计与调整
然后就是多节点流转,工具,可以 web_search, 可以多轮思考,甚至可以调用本地的读写工具。目前这些都做了基本的支持
2026-10-01 这个国庆节都在寻找当前项目的种种弊端。很多文档检索不出来,GraphRAG,Raptor,OpenViking 没有一个整理结构,它知识一个单向的数据管道,agent 被动的接受文本块进行回复。
要抽象为一些规则,按照规则建立索引,而不是做一个简单的知识库
Loading comments...